YouTube Transcript API
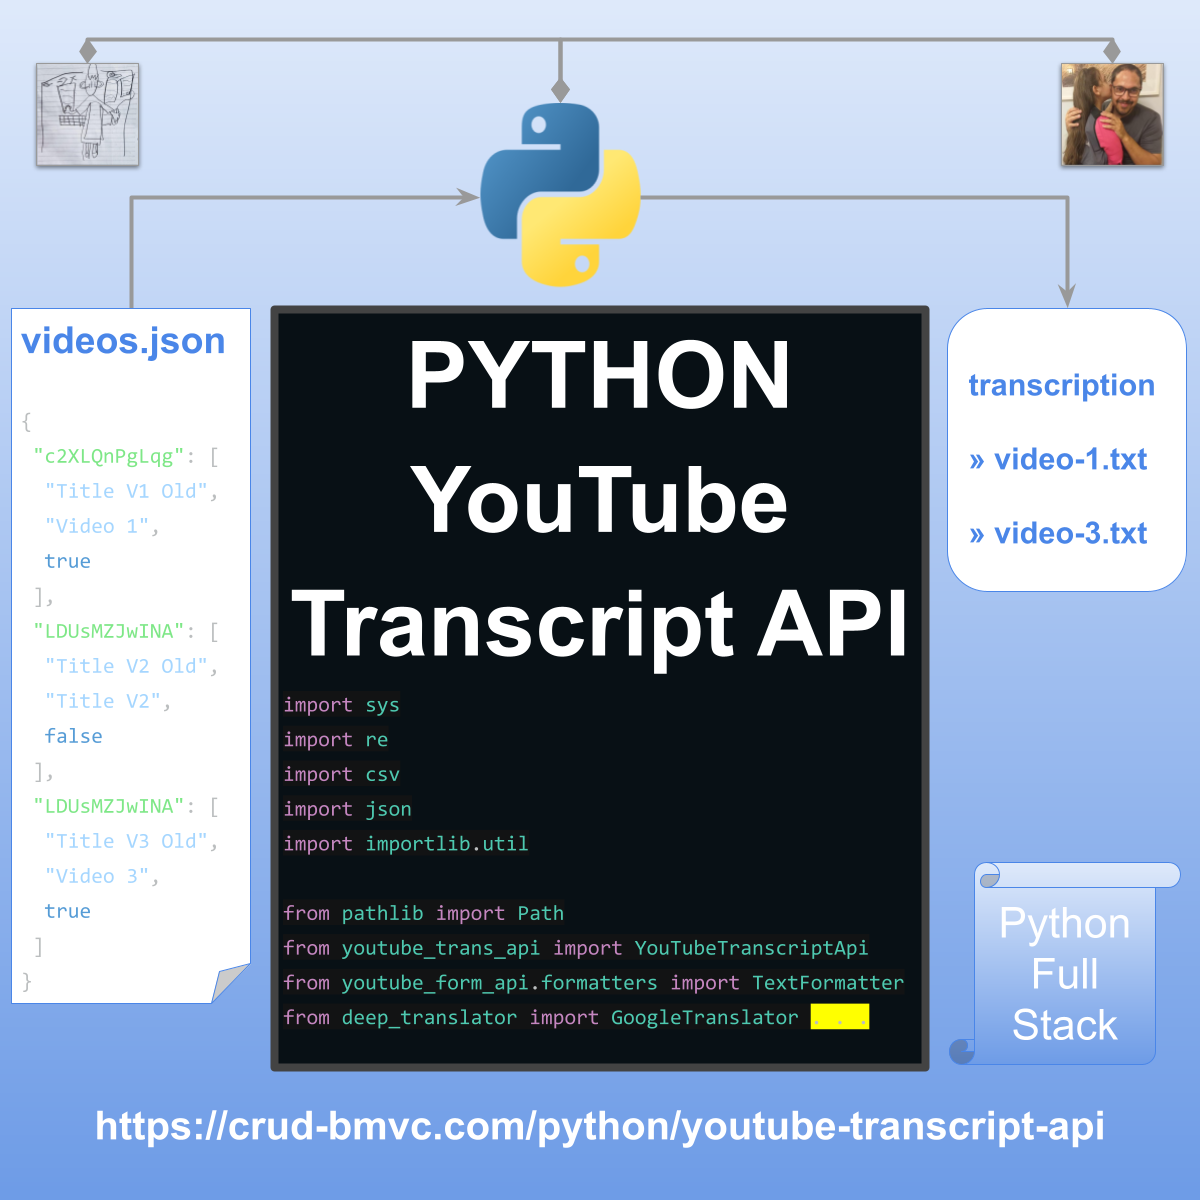
Abaixo você encontra os procedimentos para configuração e o código-fonte em Python desenvolvido para extrair e traduzir transcrições de vídeos do YouTube a partir de listas de vídeos em JSON ou CSV, salvando os resultados formatados em arquivos de texto.
Procedimento Operacional Padrão (POP)
1. Criar o ambiente virtual (venv) no Windows
Ainda não criou o seu ambiente localhost? Veja no link abaixo como fazer.
2. Instalar as bibliotecas Python
Com o ambiente virtual ativado, instale as bibliotecas externas necessárias para a extração da transcrição e tradução automática:
pip install youtube-transcript-api deep-translator3. Como configurar e utilizar o script
-
Estrutura de Rotas: O script conecta-se dinamicamente às rotas do sistema (
routes.py) para resolver automaticamente os diretórios de entrada (input_dir) e saída (output_dir) com base no nome da aplicação. -
Gerenciamento de Fontes (JSON / CSV): Sincroniza automaticamente um arquivo
videos.jsonparavideos.csve lê a lista de vídeos cadastrados contendo o ID do vídeo, título original, título personalizado e o sinalizador de ativação da transcrição. -
Extração da Transcrição: Utiliza a biblioteca
youtube-transcript-apipara buscar prioritariamente faixas em português (pt/pt-BR) ou selecione a primeira disponível caso o idioma nativo não esteja presente. -
Tradução Automática em Blocos: Se ativada a opção de tradução (
TRANSLATE_TRANSCRIPT = True), o texto é segmentado em blocos (chunking) de até 4.500 caracteres para evitar limites da API e traduzido viadeep-translator(Google Translator). -
Geração dos Arquivos de Saída: Sanitiza o título personalizado removendo caracteres especiais e salva o resultado final no diretório de saída formatado como
.txt.
Código-Fonte
# REQUEST LIB PYTHON
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
# ==================================================================
# YouTubeTranscriptionExtractor
# Extrai transcrição (opcionalmente traduzida) de vídeos do YouTube
# ==================================================================

import os
import sys
import re
import csv
import json
import importlib.util

# pyright: reportPrivateImportUsage=false
from pathlib import Path
from youtube_transcript_api import YouTubeTranscriptApi
from youtube_transcript_api.formatters import TextFormatter
from deep_translator import GoogleTranslator


# ===========================
# LOAD ROUTES.PY
# ===========================


def load_routes_module() -> list:
    try:
        root = Path(__file__).parents[3]
        routes_path = root / "app" / "builder" / "routes.py"
        if not routes_path.exists():
            raise FileNotFoundError(f"routes.py não encontrado em {routes_path}")
        spec = importlib.util.spec_from_file_location("routes", str(routes_path))
        if spec is None or spec.loader is None:
            raise ImportError("Falha ao criar ModuleSpec para routes.py")
        module = importlib.util.module_from_spec(spec)
        spec.loader.exec_module(module)  # type: ignore
        return getattr(module, "routes", [])
    except Exception as e:
        print(f"[!] Erro ao carregar routes.py: {e}")
        sys.exit(1)


def get_defaults_from_routes(app_name: str) -> tuple:
    routes = load_routes_module()
    for r in routes:
        if r.get("app", "") == app_name:
            return Path(r["input"]["path"]), Path(r["output"]["path"])
    raise RuntimeError(f"Rota não encontrada para {app_name}")


# ===========================
# CONFIG
# ===========================

APP_NAME = "YouTubeTranscriptionExtractor"
INPUT_SOURCE_INTERNAL = False
TRANSLATE_TRANSCRIPT = False
TRANSCRIPT_OUTPUT_LANGUAGE = "pt"

input_dir, output_dir = get_defaults_from_routes(APP_NAME)
input_dir.mkdir(parents=True, exist_ok=True)
output_dir.mkdir(parents=True, exist_ok=True)

# ========================
# Fonte de vídeos para teste
# ========================
ARRAY_SEARCH = {
    "Y0jSAWImghA": [
        "Titulo Original 1",
        "Titulo Personalizado 1",
        True,
    ],
    "iVTIBlnB83A": [
        "Titulo Original 2",
        "Titulo Personalizado 2",
        False,
    ],
    "N5qRlJEDE7Y": [
        "Titulo Original 3",
        "Titulo Personalizado 3",
        True,
    ],
}


# ===========================
# FUNCTIONS
# ===========================


def sync_json_to_csv():
    json_file = input_dir / "videos.json"
    csv_file = input_dir / "videos.csv"

    if not json_file.exists():
        return

    try:
        with open(json_file, "r", encoding="utf-8") as f:
            data = json.load(f)
            if not isinstance(data, dict):
                print("[!] Formato inválido no videos.json.")
                return

        with open(csv_file, "w", newline="", encoding="utf-8") as f:
            writer = csv.writer(f, delimiter=";")
            writer.writerow(
                [
                    "video_id",
                    "title_original",
                    "title_personalizado",
                    "enable_transcript",
                ]
            )
            for video_id, titles in data.items():
                if isinstance(titles, list) and len(titles) >= 3:
                    writer.writerow([video_id, titles[0], titles[1], str(titles[2])])

        print(
            f"[✓] videos.csv atualizado com base no videos.json ({len(data)} registros)."
        )

    except Exception as e:
        print(f"[!] Erro ao sincronizar JSON para CSV: {e}")


def charge_external_source() -> dict:
    json_file = input_dir / "videos.json"
    csv_file = input_dir / "videos.csv"
    data = {}
    if json_file.exists():
        with open(json_file, "r", encoding="utf-8") as f:
            raw = json.load(f)
            for k, v in raw.items():
                if isinstance(v, list):
                    title_original = v[0] if len(v) > 0 else ""
                    title_custom = v[1] if len(v) > 1 else ""
                    enable_transcript = v[2] if len(v) > 2 else True
                    data[k] = [title_original, title_custom, enable_transcript]
    elif csv_file.exists():
        with open(csv_file, "r", encoding="utf-8") as f:
            reader = csv.DictReader(f, delimiter=";")
            for row in reader:
                video_id = row.get("video_id", "").strip()
                title_original = row.get("title_original", "").strip()
                title_custom = row.get("title_personalizado", "").strip()
                enable_transcript = (
                    row.get("enable_transcript", "true").strip().lower() == "true"
                )
                if video_id:
                    data[video_id] = [title_original, title_custom, enable_transcript]
    else:
        print("[!] Nenhum arquivo videos.json ou videos.csv encontrado.")
    return data


def extract_transcription(
    video_id: str, traduzir: bool = False, idioma_destino: str = "pt"
) -> str:
    """
    Extrai a transcrição de um vídeo YouTube.
    Compatível com youtube-transcript-api v1.2.2.
    """
    try:
        # Instancia a API
        ytt_api = YouTubeTranscriptApi()

        # Lista transcrições disponíveis (TranscriptList)
        transcripts_list = ytt_api.list(video_id)

        # Tenta selecionar português, se não houver, pega qualquer transcrição disponível
        selected = None
        for t in transcripts_list:
            if t.language_code in ("pt", "pt-BR"):
                selected = t
                break
        if selected is None:
            # Pega o primeiro transcript disponível usando iterador
            selected = next(iter(transcripts_list))

        # Fetch da transcrição
        transcript_data = (
            selected.fetch()
        )  # retorna lista de dicts {'text', 'start', 'duration'}

        # Se não traduzir, retorna formatado
        if not traduzir:
            formatter = TextFormatter()
            return formatter.format_transcript(transcript_data)

        # Para tradução, monta o texto completo
        texto_original = " ".join([t.text for t in transcript_data])

        # Divide em blocos para evitar limite de caracteres do tradutor
        def dividir_em_blocos(texto, limite=4500):
            palavras = texto.split()
            blocos, atual, total = [], [], 0
            for palavra in palavras:
                total += len(palavra) + 1
                if total >= limite:
                    blocos.append(" ".join(atual))
                    atual, total = [palavra], len(palavra) + 1
                else:
                    atual.append(palavra)
            if atual:
                blocos.append(" ".join(atual))
            return blocos

        blocos = dividir_em_blocos(texto_original)
        traduzidos = [
            GoogleTranslator(source="auto", target=idioma_destino).translate(bloco)
            for bloco in blocos
        ]
        return "\n".join(traduzidos)

    except Exception as e:
        return f"Erro ao extrair transcrição: {str(e)}"


def save_transcription(video_id: str, titulo_custom: str, conteudo: str, idioma: str):
    nome_limpo = re.sub(
        r"\s+", " ", re.sub(r"[^\w\-]", " ", titulo_custom.strip())
    ).strip()
    nome_arquivo = f"{nome_limpo} - video {video_id} - transcricao {idioma}.txt"
    caminho = output_dir / nome_arquivo
    with open(caminho, "w", encoding="utf-8") as f:
        f.write(conteudo)
    print(f"[✓] Transcrição salva em: {caminho}")


# ===========================
# EXECUTE
# ===========================


def main():
    sync_json_to_csv()
    array_videos = ARRAY_SEARCH if INPUT_SOURCE_INTERNAL else charge_external_source()
    for video_id, titulos in array_videos.items():
        if len(titulos) < 3 or not titulos[2]:
            continue
        titulo_original, titulo_custom, _ = titulos
        try:
            texto = extract_transcription(
                video_id, TRANSLATE_TRANSCRIPT, TRANSCRIPT_OUTPUT_LANGUAGE
            )
            if not texto.startswith("Erro"):
                save_transcription(
                    video_id, titulo_custom, texto, TRANSCRIPT_OUTPUT_LANGUAGE
                )
            else:
                print(f"[X] {titulo_original}: {texto}")
        except Exception as e:
            print(f"[!] Erro geral em {video_id} - {titulo_original}: {e}")

    print("\n🏁 Processo concluído.")


if __name__ == "__main__":
    main()